De uitdrukking "je eigen AI-vriendin draaien" klinkt als één programma. In de praktijk zijn het drie onderdelen die met elkaar praten, en als je begrijpt welk onderdeel wat doet, voorkom je het grootste deel van de frustratie.
De drie onderdelen
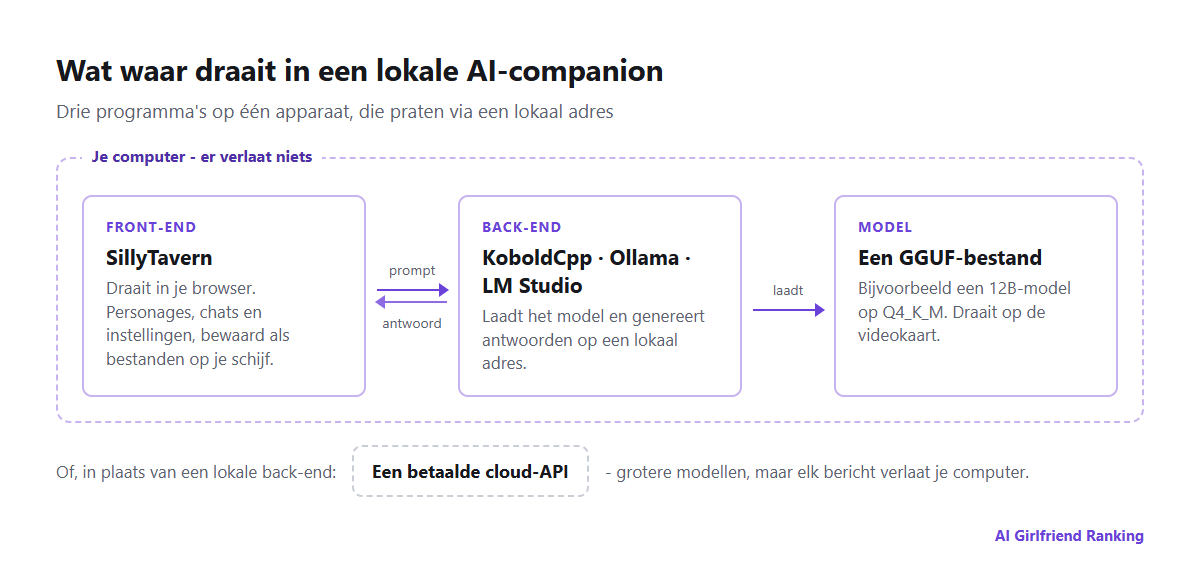
Wat met wat praat in een typische lokale opzet.
De front-end is wat je ziet: chatvensters, personages, avatars, instellingen. SillyTavern is de standaardkeuze voor personagechat. Het draait in je browser, bewaart personages en chats als bestanden op je schijf en kan verbinding maken met bijna elke back-end. Zelf genereert het geen tekst.
De back-end laadt het model en genereert de antwoorden. KoboldCpp is één programma zonder installatie dat geliefd is voor rollenspel omdat het elke generatie-instelling laat zien. Ollama is de makkelijkste manier om met een paar commando's een model draaiend te krijgen. LM Studio is een desktop-app met een prettige modelbrowser. Elk van deze programma's stelt het model beschikbaar op een lokaal adres waarmee de front-end verbinding maakt.
Het model is een groot bestand, meestal in het GGUF-formaat, gedownload van Hugging Face. De grootte in parameters - 8B, 12B, 24B - en de kwantisatie bepalen hoe goed het is en welke hardware het nodig heeft.
De hardwarevraag
Of een model goed draait, hangt af van het videogeheugen (VRAM). Het model moet erin passen, plus ruimte voor het gesprek zelf. Kwantisatie krimpt modellen zodat ze passen: "Q4_K_M" is het gangbare compromis tussen grootte en kwaliteit.
| Modelgrootte | Geheugen bij Q4 (circa) | Typische hardware | Wat je kunt verwachten |
|---|---|---|---|
| 7-8B | 5-6 GB | Videokaart met 8 GB | Samenhangend, snel, vergeet details in lange scènes |
| 12-14B | 9-10 GB | Kaart met 12 GB | Merkbaar betere personages en schrijfstijl |
| 22-24B | 14-16 GB | Kaart met 16-24 GB | Dicht bij goede gehoste apps voor rollenspel |
| 70B | 40 GB+ | Twee kaarten of een Mac met veel geheugen | Uitstekend, traag en duur |
Deze cijfers zijn grof: een langere context vraagt extra geheugen. Apple Silicon-Macs delen het geheugen tussen processor en grafische chip, dus een MacBook met 32 GB kan modellen draaien die een videokaart met 12 GB niet aankan. Een model dat niet past, loopt over naar de hoofdprocessor en kruipt: komen de antwoorden binnen met een paar woorden per seconde, stap dan over op een kleiner model voordat je een hardere kwantisatie probeert. Een kleiner model in goede kwaliteit wint meestal van een groter model dat te hard is samengeperst.
Wat je wint
- Privacy die niet van een beleid afhangt. Er verlaat niets je apparaat. Geen bewaartermijn, geen training, geen toegang voor medewerkers, niets om later te verwijderen.
- Geen filter behalve dat van het model zelf. Jij kiest het model, ook modellen die specifiek op rollenspel zijn afgestemd. De wettelijke ondergrens voor content geldt nog steeds voor jou, maar geen aanbieder legt er regels bovenop.
- Geen abonnement en geen credits. Genereer zoveel je wilt.
- Personages die van jou zijn. Personagekaarten zijn gewone PNG-afbeeldingen met het personageblad erin ingebed. Ze gaan mee tussen front-ends en een update kan ze je niet afnemen.
- Stabiliteit. Een model dat vandaag werkt, werkt over vijf jaar nog hetzelfde. Niemand kan het onder je vandaan wisselen - het risico dat wordt beschreven in wanneer je AI-companion van de ene op de andere dag verandert.
Wat je inlevert
- Insteltijd. Reken op een avond voor het eerste werkende gesprek, en op weken sleutelen als je dat leuk vindt.
- Geheugen is jouw taak. Gehoste apps vatten stilletjes dingen samen en bewaren feiten over jou. Lokaal beheer je dat zelf met de lorebooks, samenvattingen en personagenotities van SillyTavern - dezelfde drie mechanismen als in hoe het geheugen van een AI-companion werkt, alleen liggen de knoppen nu open en bloot.
- Beelden en stem zijn aparte projecten. Beeldgeneratie heeft een eigen model en meestal meer videogeheugen nodig; stem vraagt om spraakherkenning en spraaksynthese. Alles kan, niets gaat vanzelf.
- Mobiel is onhandig. Je kunt de front-end vanaf je telefoon openen via je wifi thuis. Onderweg gebruiken betekent dat je je computer aan het internet blootstelt, en dat vraagt om zorg.
- Kwaliteitsplafond. De beste gehoste modellen zijn groter dan alles wat de meeste mensen thuis kunnen draaien, zeker voor consistentie op de lange termijn.
De tussenweg en de adder onder het gras
Veel mensen draaien SillyTavern op hun eigen apparaat maar koppelen het aan een betaalde cloud-API in plaats van aan een lokaal model. Je krijgt de controle en de personagebestanden van de front-end, veel grotere modellen en betalen per bericht, wat bij licht gebruik goedkoop kan zijn.
Privé is het alleen niet. Elk bericht gaat naar de API-aanbieder, onder diens logging, bewaartermijnen en contentregels - vaak strenger over rollenspel dan speciale companion-apps. Het is een andere afweging, geen lokale opzet.
Basisregels voor veiligheid
- Download software alleen van de officiële projectpagina's op GitHub of de eigen site van het project.
- Download modellen van bekende uploaders op Hugging Face en kies bij voorkeur GGUF-bestanden: die bevatten modelgegevens in plaats van code.
- Lees de licentie van het model. Sommige beperken commercieel gebruik; enkele beperken bepaalde content.
- Houd SillyTavern gebonden aan je eigen apparaat of thuisnetwerk, tenzij je een wachtwoord hebt ingesteld en begrijpt wat je blootstelt.
SillyTavern wordt openlijk ontwikkeld op GitHub.
Voor wie het is
Draai een companion lokaal als privacy je grootste zorg is, je al over krachtige hardware beschikt of je het instellen minstens zo leuk vindt als het gebruiken. Blijf bij een gehoste app als je stem, beelden en een lang geheugen kant-en-klaar wilt, of vooral op je telefoon chat. Onze gids voor het kiezen van een eerste app behandelt die route. Veel mensen eindigen met beide: een gehoste app voor het gemak en een lokale opzet voor de gesprekken die ze liever nergens anders opgeslagen willen hebben.